Ученые предложили использовать векторную символьную архитектуру для получения распутанных представлений
Представление данных для машинного обучения — это важный этап, от которого зависит качество работы алгоритма. Первоначально задача получения хороших представлений решалась с помощью инженерии признаков, т. е. ручного выбора, создания и генерации таких признаков, которые позволяют модели успешно решать основную задачу. Сейчас исследователи стараются автоматизировать этот процесс.
Сегодня существует несколько подходов к этой задаче: поиск близости представлений для семантически связанных объектов, выявление у них общих черт, сохранение сложной структуры с уменьшением размерности и распутанные представления. В последнем случае нужно факторизовать порождающие переменные (generative factors) так, чтобы один признак охватывал не более одной переменной. Кроме того, каждая лежащая в основе порождающая переменная должна быть отражена признаком, а само представление должно быть информативным, то есть обеспечивающим полноту знаний о них.
Распутанное представление может потенциально улучшить обобщение и объяснимость (generalization and explainability) во многих задачах машинного обучения: создание структурированных сцен, обучение с подкреплением, объектно-ориентированные визуальные задачи и многое другое.
Векторная символьная архитектура
Сегодня наиболее распространен локалистский подход к представлению данных, основанный на том, что каждой переменной ставится в соответствие компонента некоторого вектора. Исследователи из ФИЦ ИУ РАН и AIRI вместе с коллегами предлагают вместо этого сопоставлять каждой переменной отдельный вектор той же размерности, что и результирующее представление. Это возможно благодаря использованию векторной символьной архитектуры (Vector Symbolic Architercutres, VSA) — фреймворка, в котором символы представляются в виде высокоразмерных векторов и который позволяет оперировать с символами как с векторами.
В работе этой архитектуры используется набор атомарных (seed) векторов, которые получают путем выборки из заданного многомерного пространства. С чрезвычайно высокой вероятностью все они не похожи друг на друга (квазиортогональны), что позволяет свести манипуляции с символами к векторным операциям. Для каждой порождающей переменной авторы сэмплировали столько затравочных векторов, сколько существует возможных ее значений.
После этого каждый объект, обладающий совокупностью переменных, может быть отображен в латентное пространство признаков, в котором ими можно манипулировать. Например, это могут быть признаки, представляющие какие-либо свойства объектов на изображениях: цвет, форму и так далее. Тогда становится возможным обмен признаками между изображениями с разными объектами (основным и донорным), подвергнутыми такому распутыванию.
Обмен признаками
Исследователи проделали это для сцен, содержащих простые геометрические фигуры. Для этого каждое изображение попадало сначала в энкодер в модуле проекции порождающих переменных (Generative Factors Projection), который формирует набор промежуточных векторов. Эти векторы поступают в модуль представления порождающих переменных (Generative Factor Representation), где под действием механизма внимания они преобразуются в линейные комбинации атомарных векторов. Эти линейные комбинации и есть искомые векторы, характеризующие объект с точки зрения распутанного представления.
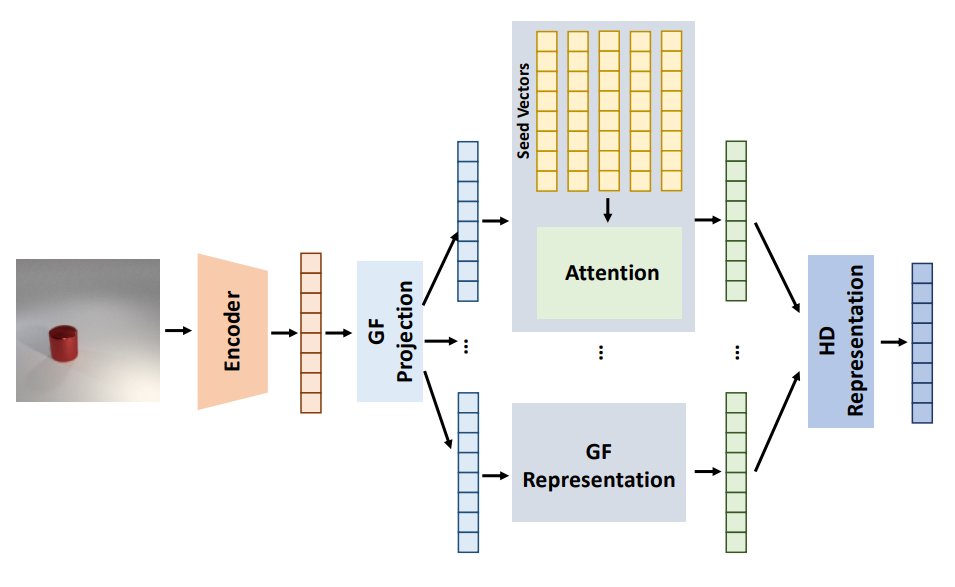
Схема распутанного представления на основе векторной символьной архитектуры
Для демонстрации работы этого алгоритма ученые применили его к объектам из наборов данных CLEVR и dSprites. Эксперимент заключался в представлении геометрических объектов, обладающих некоторой формой, цветом, размером, материалом и координатами, в виде совокупности векторов в латентном пространстве согласно описанному выше алгоритму. Авторы проверяли, действительно ли удается добиться распутанности в этом случае, меняя признаки между парами представлений объектов в латентном пространстве и восстанавливая изображения по этим представлениям.
В случае с данными dSprites все признаки с некоторыми погрешностями удалось успешно перенести с объекта-донора на основной объект. Исследователи отметили, что признаки «форма» и «ориентация» связаны друг с другом сильнее, чем с другими признаками. По их мнению, это вызвано наличием у некоторых фигур (эллипса, квадрата и других) вращательных симметрий. Для фигур из набора CLEVR алгоритм хорошо справился с распутыванием признаков «цвет», «размер» и «материал», но в отличие от объектов из dSprites обмен координатами происходил с ошибкой.
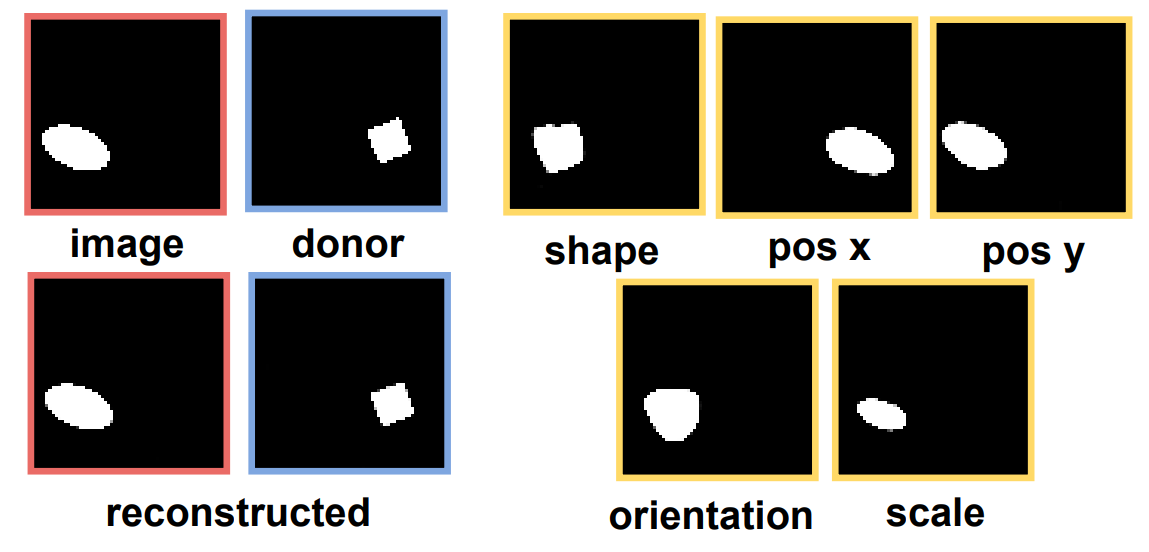
Результат кодирования и последующей реконструкции исходного (эллипс) и донорского (квадрат) объектов (слева), а также переноса признаков от одного к другому (справа)
По мнению ученых, новых подход имеет преимущество перед локалистскими методами в устойчивости представлений объектов при манипуляциях в латентном пространстве. Они отмечают, что для его использования необходимо заранее знать число генерирующих переменных, что не всегда возможно в реальных данных. В будущем авторы планируют обобщить предложенную модель для решения этой проблемы.
Подробнее с работой можно ознакомиться в статье, опубликованной в сборнике трудов конференции ICLR 2023.