Что такое модель принятия решений: как устроен Jev и чем он отличается от LLM
Специализированная модель принятия решений — это нейросеть, которая не пишет текст, а выбирает ответ из заданных разработчиком вариантов и сообщает, насколько в нём уверена. На вопрос «В какой отдел направить обращение: оплата, техподдержка или продажи?» она вернёт не абзац, а значение «техподдержка» и вероятности для всех вариантов. Программа сразу использует такой ответ в коде.
Первой такой моделью, вышедшей как публичный продукт, стала Jev от компании TypeSafe AI: его выпустили в ранний доступ 15 сентября 2026 года. Сама компания называет этот класс «моделями System One» (System One Models), а в прессе и научных статьях прижилось название «модель принятия решений» (decision model). Словосочетание «System One» отсылает к книге Даниэля Канемана о быстром и медленном мышлении, а сам Jev назван в честь экономиста Уильяма Стэнли Джевонса, который заметил, что удешевление ресурса увеличивает его потребление.
Если LLM генерируют текст токен за токеном, то модели типа Jev за один проход возвращают готовое решение. Они не заменяют ChatGPT или Claude, а работают внутри программ: маршрутизируют запросы, модерируют контент, проверяют ответы других моделей.
Как работает специализированная модель принятия решений?
Это модель с ограниченным набором ответов: она читает текст на естественном языке, но отвечает только вариантами из списка. Слово «специализированная» относится к формату ответа, а не к теме. Один и тот же Jev оценивает жалобу клиента, договор или ход в игре.
Пример: интернет-магазину нужно распределять обращения по пяти категориям. Правило «есть слово "вернуть" — значит, категория "возвраты"» ошибётся на фразе «верните деньги за двойное списание», которая на самом деле относится к оплате. LLM поймёт смысл, но ответит через несколько секунд и иногда добавит лишние слова. Модель принятия решений тоже понимает смысл, но отвечает строго одним из пяти вариантов и за доли секунды.
Почему это быстрее? Языковая модель тратит основное время на последовательную генерацию: каждый следующий токен зависит от предыдущего, поэтому их нельзя посчитать одновременно. Если LLM рассуждает перед ответом, токенов становится сотни или тысячи. Модели принятия решений достаточно одного прохода по входу. TypeSafe пишет, что Jev вычисляет все ответы параллельно, в одном запросе. В документации приведён пример: 13 вопросов в одном вызове обошлись в 11,5 раза дешевле и отработали в 9,6 раза быстрее, чем 13 отдельных вызовов, при тех же ответах.
Запрос к Jev состоит из состояния (текста или JSON) и набора вопросов. Вопросы бывают трёх типов: Choice — выбор из вариантов, Score — уровень на шкале, Noul — вероятность ответа «да». На все вопросы запроса модель отвечает параллельно, поэтому лишний вопрос почти не замедляет ответ.
Jev обучают методом RLCD — обучением с подкреплением для откалиброванных решений. Цель метода — чтобы модель, уверенная на 90%, оказывалась права примерно в 9 случаях из 10. Тогда программа может выполнять уверенные решения сама, а сомнительные передавать человеку. Размер и базовую модель Jev TypeSafe не раскрывает, а доступ к модели есть только через облачный API.
Внутри это всё ещё трансформер — та же архитектура, на которой построены LLM. Модель читает входной текст и строит его внутреннее представление. Разница в последнем шаге. LLM после чтения начинает предсказывать следующий токен, потом ещё один, и так до конца ответа. Модель принятия решений вместо этого сразу оценивает разрешённые варианты и выдаёт распределение вероятностей по ним.
Чем модель принятия решений отличается от LLM?
LLM генерирует произвольный текст по одному токену, а модель принятия решений выбирает из вариантов за один проход. Из этого следуют отличия в цене, скорости и надёжности формата.
• Скорость. По данным TypeSafe, Jev отвечает за 70–500 миллисекунд, а передовые LLM — за 3–329 секунд.
• Цена. У Jev — $0,042 за миллион входных токенов, выходные токены бесплатны. У LLM вход стоит $0,20–10 за миллион токенов.
• Формат. Jev не может вернуть вариант, которого нет в списке, или сломанный JSON.
• Уверенность. Вероятности приходят в каждом ответе. В бенчмарке JEVal ошибка калибровки у Jev составила 0,053, а у самой точной из протестированных LLM — 0,116.
Цифры производителя подтверждаются и независимо. Исследование, где разные модели использовались в роли «судей», оценивающих ответы по рубрике, показало, что LLM обошлись в 16–325 раз дороже Jev.
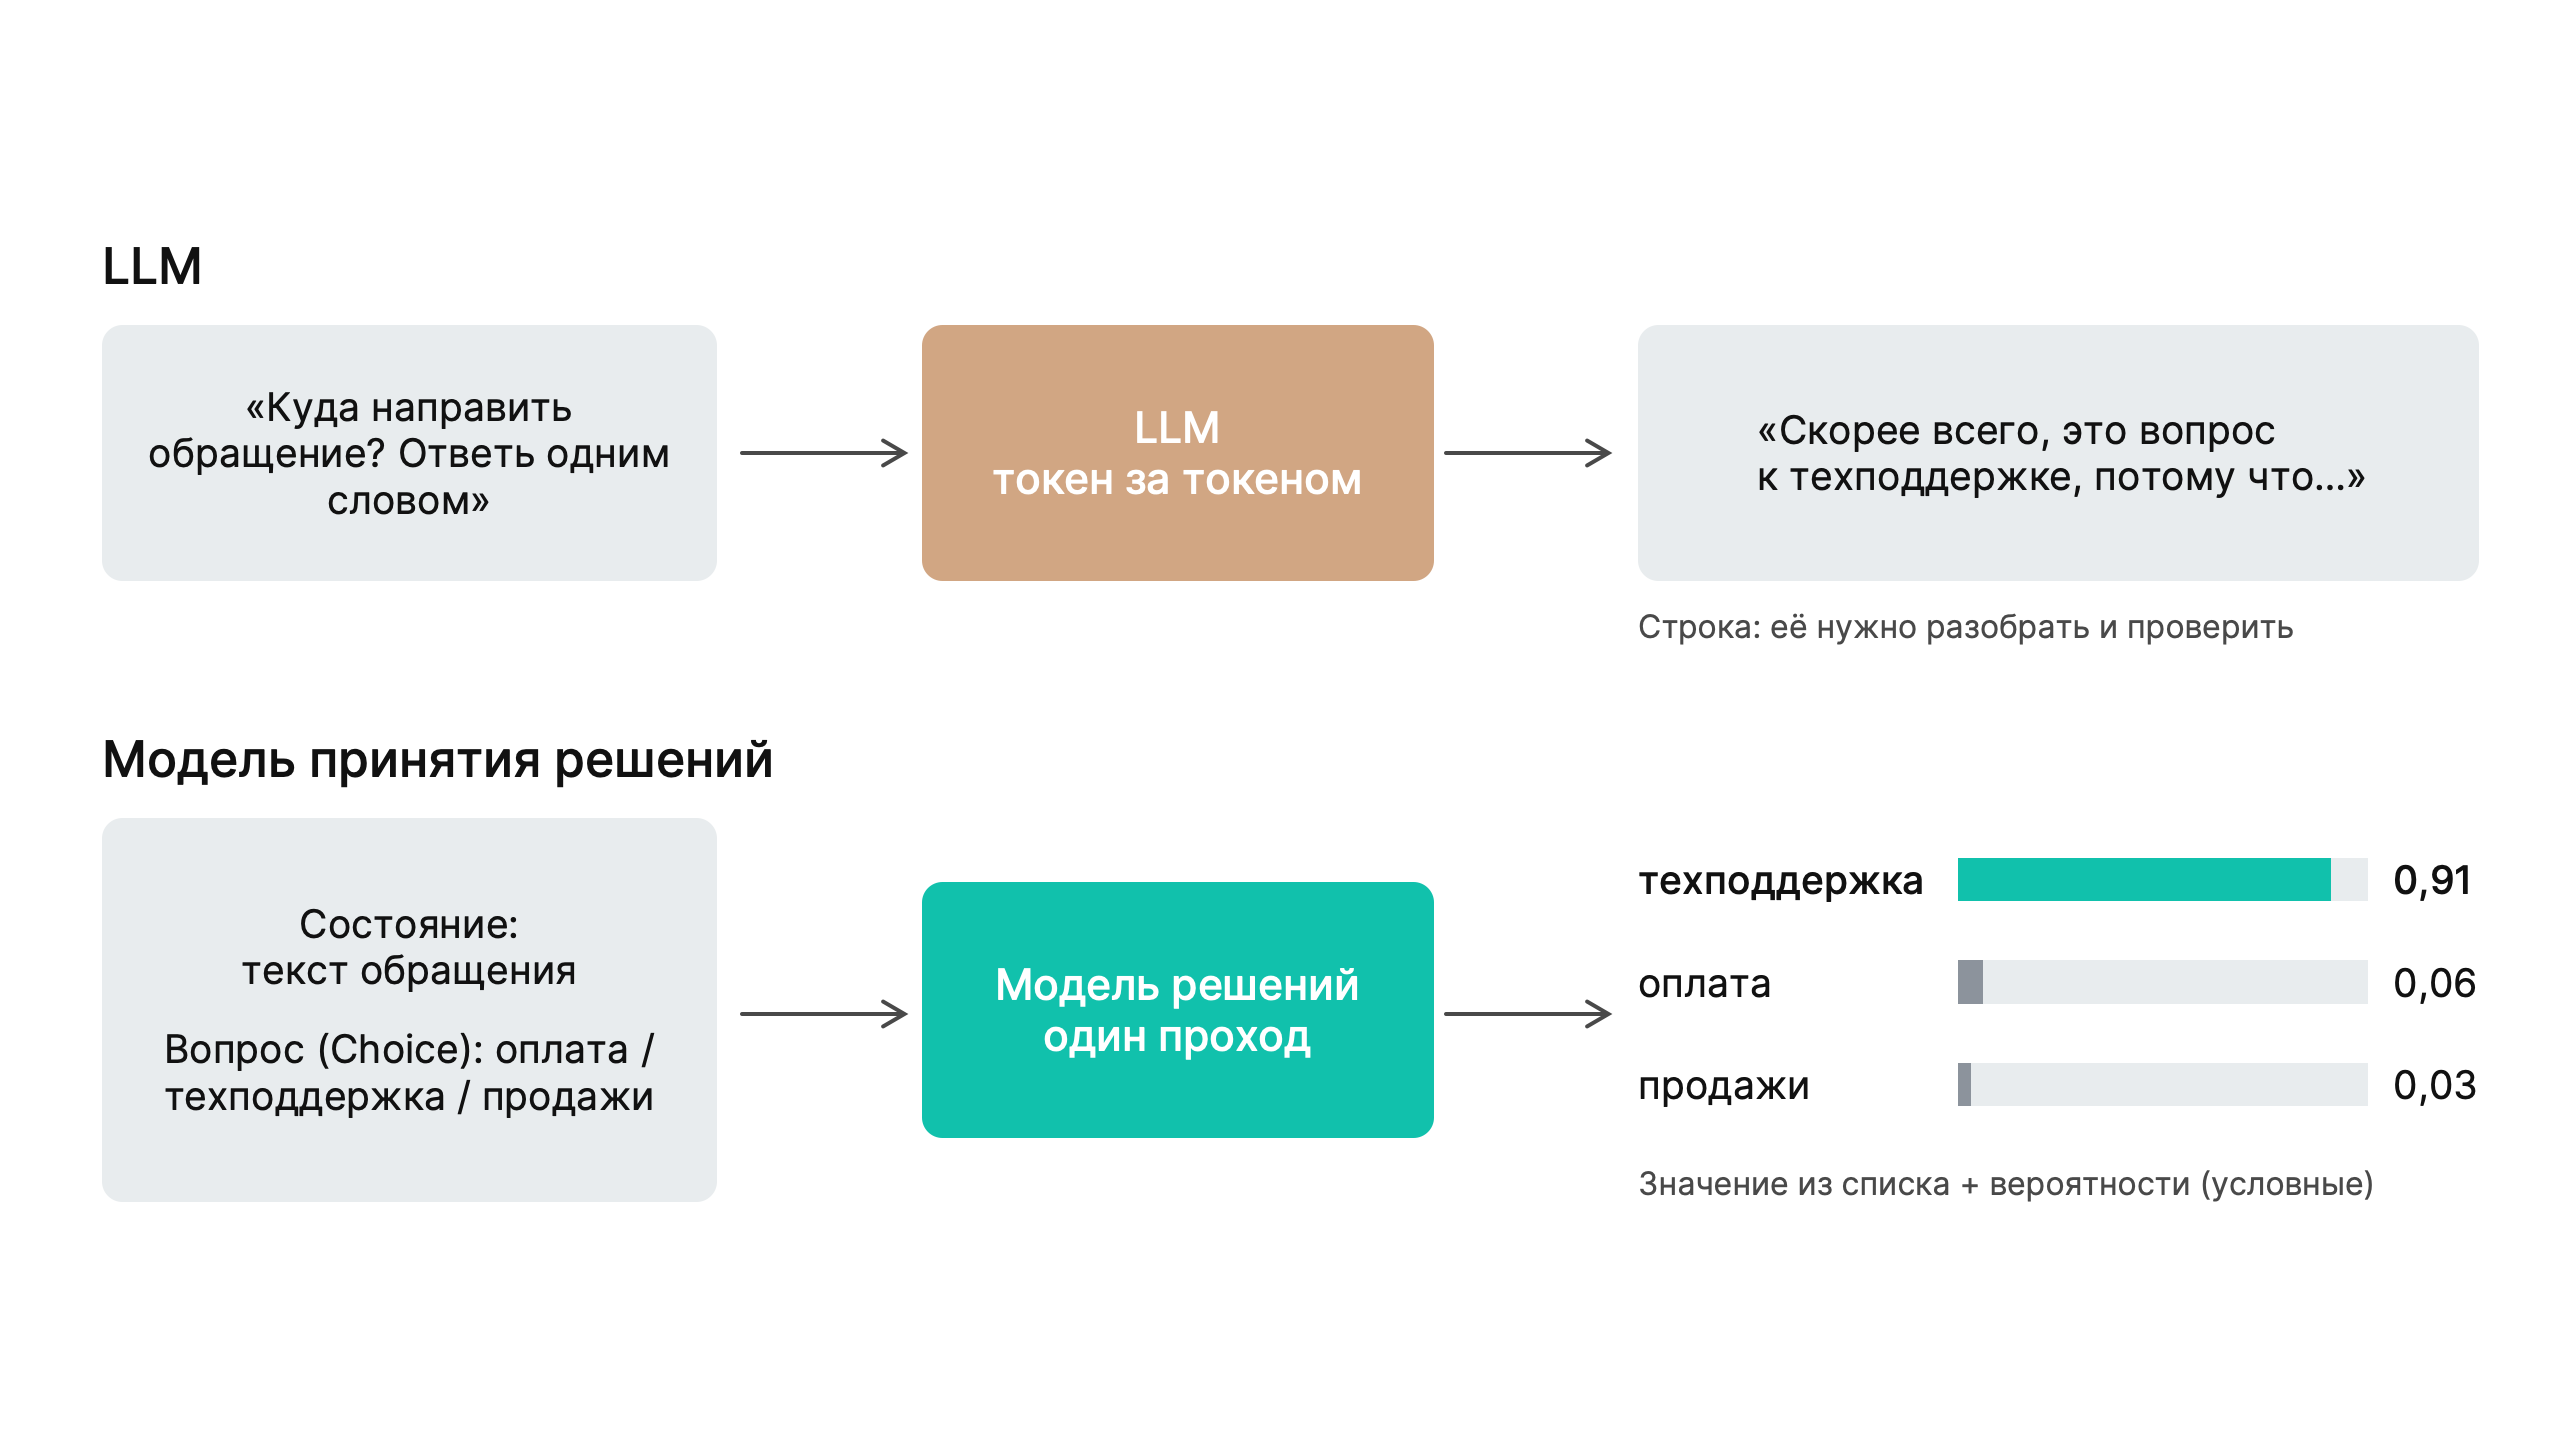
LLM получает текст и возвращает текст; модель принятия решений получает состояние и вопросы и возвращает вариант с вероятностями.
У модели принятия решений есть и слабые места. Исследователи из Даляня показали, что Jev не уступает передовым LLM на задачах на знания, но заметно отстаёт в математике. В JEVal Jev уступал LLM в медицине, финансах и праве. Модель гарантирует формат ответа, но не его правильность.
Поэтому эти модели используют вместе с LLM: модель принятия решений маршрутизирует и проверяет, а LLM пишет тексты и рассуждает. Такой принцип работы демонстрирует широкую универсальность. Например, связка GPT-6 Astra и Jev смогла пройти Minecraft всего за 8 минут 43 секунды.
Какие есть альтернативы Jev?
Главные альтернативы Jev — открытые модели, которые можно запустить на своём компьютере или сервере. Многие из них совместимы с API Jev. Ниже лишь несколько примеров:
• Kev — семейство моделей на основе Qwen размером от 0,8 до 27 миллиардов параметров.
• Nimble от Bespoke Labs, 9 миллиардов параметров.
• Tev1 от Together AI — экспериментальные модели на 4 и 0,8 миллиардов параметров.
• InnerJev из Фуданьского университета, есть версии на 4 и на 27 миллиардов параметров.
• Laya и Von — компактные модели на основе ModernBERT, около 400 миллионов параметров, для простых задач.
Существуют и проприетарные модели, например, Microsoft-Decision-1 от Microsoft. В таком случае Jev и аналоги работают как облачная услуга с оплатой за объём: $0,042 за миллион входных токенов. Миллион токенов — это несколько тысяч коротких обращений в поддержку, поэтому один запрос стоит доли цента. Открытые модели вроде Kev или Nimble распространяются бесплатно, в том числе для коммерческого использования. Но «бесплатно» здесь значит «без абонентской платы»: модель нужно где-то запустить, а значит, платить за компьютер или сервер и электричество. Для небольших моделей хватит мощного ноутбука. Модели на 27 миллиардов параметров нужна серверная видеокарта, и такие расходы окупаются только при большом потоке запросов.
Поэтому выбор чаще зависит не от цены одного запроса, а от двух вещей: сколько решений нужно принимать и можно ли отправлять данные за пределы компании. Небольшому проекту проще и дешевле подключить облачную модель и платить по факту. Банку или клинике, которым нельзя передавать данные клиентов внешнему сервису, логичнее запустить открытую модель на своём оборудовании: так данные никуда не уходят, а стоимость не растёт с каждым новым запросом.
Заключение
Если кратко подытоживать написанное, модель принятия решений похожа на опытного сотрудника, который за секунду сортирует входящие письма по папкам, но не напишет ни одного ответа. Языковая модель вроде GPT или Claude больше похожа на собеседника: она может обсудить письмо, объяснить его и составить ответ, но тратит на это заметно больше времени и денег. Внутри программ большинство вопросов к ИИ — как раз вопросы первого рода: «да или нет», «какой из трёх вариантов». Для них собеседник не нужен.
Насколько перспективно это направление, пока сказать трудно. Технологии меньше двух месяцев, и самые впечатляющие цифры о скорости и цене опубликовал сам разработчик. Но есть два признака, что это не мимолётная мода. Первый: за считаные недели энтузиасты и исследователи выпустили бесплатные аналоги. Некоторые из них по точности уже догнали Jev, и их можно запустить на обычном ноутбуке. Второй: идея решает реальную проблему. Когда решение стоит доли копейки и занимает доли секунды, ИИ можно поручить тысячи мелких проверок, которые раньше было дорого автоматизировать.
Ограничения тоже понятны. Такая модель ошибается, и иногда делает это уверенно, плохо справляется со счётом, а в длинных цепочках действий её ошибки накапливаются. Поэтому, скорее всего, модели принятия решений не вытеснят привычные чат-боты, а станут их незаметными помощниками: будут работать «под капотом» приложений, разбирать, проверять и сортировать, пока языковые модели говорят с людьми.